为视频语义搜索优化模型,需要在准确率、成本和延迟之间取得平衡。更快、更小的模型缺乏路由智能,而更大、更准确的模型又会带来明显的延迟开销。在本系列的第 1 部分中,我们展示了如何在 AWS 上使用 Amazon Bedrock 中的 Anthropic Claude Haiku 模型,通过智能意图路由构建多模态视频语义搜索系统。虽然 Haiku 模型在用户搜索意图识别方面准确率较高,但会将端到端搜索时间增加到 2–4 秒。这部分占到了总延迟的 75%。
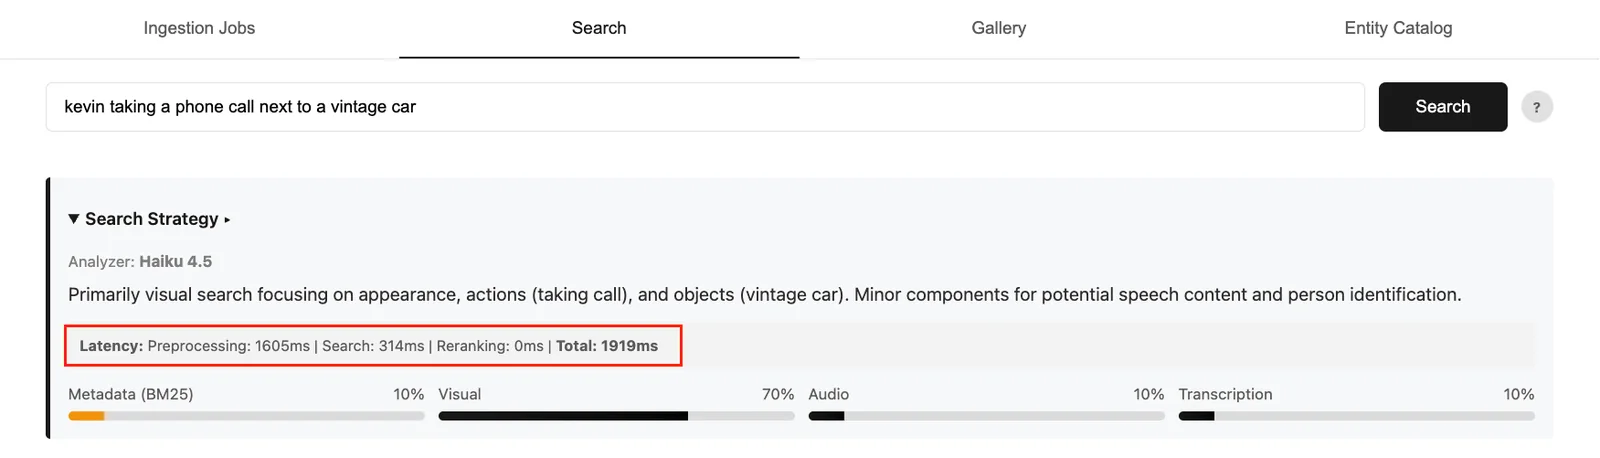
图 1:端到端查询延迟拆分示例
再来看当路由逻辑变得更复杂时会发生什么。企业元数据可能远比我们示例中的 5 个属性(标题、字幕、人物、类型和时间戳)复杂。客户还可能会纳入镜头角度、情绪与情感、许可与权利窗口,以及更多特定领域的分类体系。逻辑越细致,提示词要求就越高;提示词要求越高,响应就越慢、成本也越高。这正是模型定制发挥作用的地方。我们不必在“快速但过于简单”的模型与“准确但过于昂贵或过慢”的模型之间二选一,而是可以通过训练一个小模型,让它以更低的延迟和成本准确完成这项任务。
本文将展示如何使用 Amazon Bedrock 上的一种模型定制技术 Model Distillation,把大型教师模型 Amazon Nova Premier 的路由智能迁移到小得多的学生模型 Amazon Nova Micro。这种方法在保持任务所需细致路由质量的同时,将推理成本降低 95% 以上,并将延迟降低 50%。
方案概览
我们将在一个 Jupyter notebook 中端到端演示完整的蒸馏流程。从高层来看,该 notebook 包含以下步骤:
完整的 notebook、训练数据生成脚本和评估工具都已在 GitHub 仓库中提供。
准备训练数据
我们选择模型蒸馏而不是监督式微调(SFT)等其他定制技术,其中一个关键原因是它不要求完整标注数据集。使用 SFT 时,每个训练样本都需要人工生成的响应作为真实标签。使用蒸馏时,你只需要提供提示词。Amazon Bedrock 会自动调用教师模型生成高质量响应,并在后台应用数据合成与增强技术,产出最多 15,000 组多样化的提示词-响应对训练数据。
话虽如此,如果你希望对训练信号有更多控制,也可以选择提供标注数据集。JSONL 文件中的每条记录都遵循 bedrock-conversation-2024 模式,其中 user 角色(输入提示词)是必填项,assistant 角色(期望响应)是可选项。可参考下面的示例,以及“Prepare your training datasets for distillation”获取更多细节:
在本文中,我们使用 Nova 系列中最大、能力最强的模型 Nova Premier,准备了 10,000 条合成标注样本。数据在视觉、音频、转录文本和元数据信号查询之间保持了均衡分布。这些样本覆盖了预期搜索输入的完整范围,体现了不同难度层级,包含边界情况和变体,并避免对狭窄查询模式过拟合。下图展示了 4 个模态通道的权重分布。
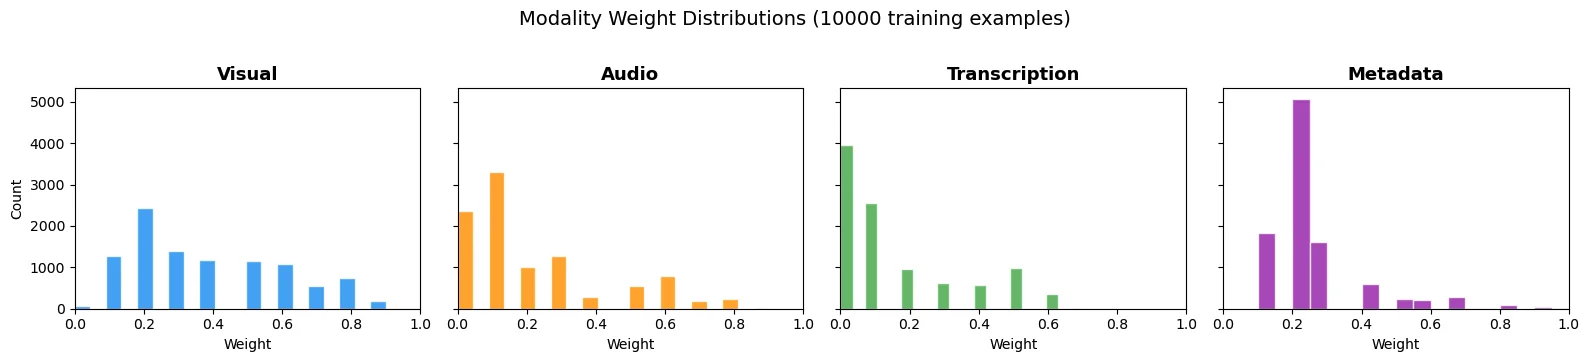
图 2:10,000 个训练样本在四个模态通道上的权重分布
如果你需要更多样本,或者希望让查询分布适配自己的内容领域,可使用提供的 generate_training_data.py 脚本,通过 Nova Premier 合成生成更多训练数据。
运行蒸馏训练任务
将训练数据上传到 Amazon S3 后,下一步就是提交蒸馏任务。模型蒸馏的工作方式是先用你的提示词生成教师模型的响应,再用这些提示词-响应对来微调学生模型。在这个项目中,教师模型是 Amazon Nova Premier,学生模型是 Amazon Nova Micro,后者是一个面向高吞吐推理优化、快速且高性价比的模型。教师模型的路由决策会成为塑造学生模型行为的训练信号。
Amazon Bedrock 会自动管理整个训练编排和基础设施。不需要预置集群,不需要调节超参数,也不需要搭建教师到学生的模型流水线。你只需指定教师模型、学生模型、训练数据的 S3 路径,以及具备必要权限的 AWS Identity and Access Management(IAM)角色,剩下的由 Bedrock 处理。下面是触发蒸馏训练任务的示例代码片段:
该任务会异步运行。你可以在 Amazon Bedrock 控制台的 Foundation models > Custom models 下监控进度,也可以通过编程方式监控:
训练时间会因数据集大小和所选学生模型而异。对于使用 Nova Micro 的 10,000 条标注样本,通常预计任务会在数小时内完成。
部署蒸馏后的模型
蒸馏任务完成后,自定义模型就会出现在你的 Amazon Bedrock 账户中,并可随时部署。Amazon Bedrock 为自定义模型提供两种部署方式:适用于可预测高负载场景的 Provisioned Throughput,以及适用于灵活按量付费、无需前期承诺的 On-Demand Inference。
对于大多数刚开始使用的团队,推荐采用按需推理路径。无需预置端点,无需按小时承诺,也没有最低使用量要求。下面是部署代码:
当状态显示为 InService 后,你就可以像调用任何其他基础模型一样,使用标准的 InvokeModel 或 Converse API 调用蒸馏后的模型。你只需按 Nova Micro 的推理费率为实际消耗的 token 付费:每 1,000 个输入 token 为 0.000035 美元,每 1,000 个输出 token 为 0.000140 美元。
评估蒸馏后的模型
在与原始路由器对比之前,值得先验证蒸馏是否提升了基础模型遵循路由任务的能力。下表展示了同一提示词分别通过基础版 Nova Micro 和蒸馏版 Nova Micro 运行后的并排结果。
下面是一个视频搜索查询的 JSON 表示,查询内容是一位 CEO 讨论季度收益:
```json{ "video": { "visual": 0.3, "audio": 0.3, "transcription": 0.2, "metadata": 0.1, "reasoning": "视觉部分包括 CEO 的出镜……"
下面是视频搜索查询“sunset over mountains”的 JSON 表示,其中包含视觉、音频、转录文本、元数据权重(总和 = 1.0)以及推理说明:
```json{ "query": "sunset over mountains", "results": [ { "video_id": "123456", "visual": 0.4, "audio": 0.3 ....
基础模型在遵循指令和输出格式一致性两方面都存在困难。它会输出自由文本、不完整的 JSON,以及非数值型的权重值。蒸馏后的模型则可以稳定返回结构完好的 JSON,其中包含 4 个数值型权重,且总和为 1.0,符合路由流水线要求的模式。
在与原始 Claude Haiku 路由器对比时,两种模型都在一组由 Nova Premier 生成、留出的 100 条标注样本上进行评估。我们使用 Amazon Bedrock Model Evaluation,以结构化、托管式工作流运行比较。为了在标准指标之外评估路由质量,我们定义了一个自定义的 OverallQuality 评分规则(见后续代码块),指导 Claude Sonnet 从两个维度为每个预测打分:一是相对于真实标签的权重准确性,二是推理质量。每个维度都对应明确的 5 分阈值,因此该规则会同时惩罚数值漂移和泛化、模板化的推理表述。
蒸馏后的 Nova Micro 模型获得了 4.0/5 的大语言模型(LLM)即评委分数,在路由质量上与 Claude 4.5 Haiku 几乎相同,但延迟约减半(833ms 对 1,741ms)。成本优势也同样明显。切换到蒸馏版 Nova Micro 后,在按需定价模式下,输入和输出 token 的推理成本都可降低 95% 以上,且无需前期承诺。注意:LLM-as-judge 评估具有非确定性,不同运行之间分数可能会略有波动。
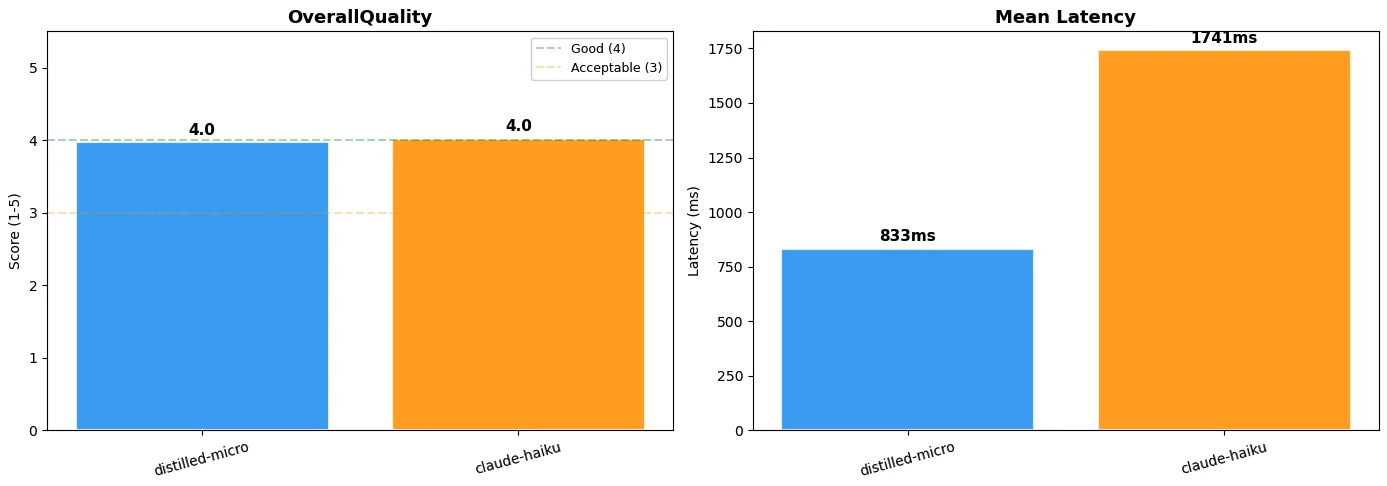
图 3:模型性能对比(Distilled Nova Micro vs. Claude 4.5 Haiku)
下表为并排结果汇总:
清理
为了避免持续产生费用,请运行 notebook 中的清理部分,删除任何已预置资源,包括已部署的模型端点以及存储在 Amazon S3 中的任何数据。
结论
本文是这一两部分系列文章中的第二部分。承接第 1 部分,本文重点介绍如何将模型蒸馏应用到视频语义搜索解决方案中的意图路由层优化。文中讨论的技术有助于应对真实生产环境中的权衡,例如在保持搜索准确率的同时,在规模化场景下平衡路由智能、延迟和成本。通过使用 Amazon Bedrock Model Distillation,将 Amazon Nova Premier 的路由行为蒸馏到 Amazon Nova Micro,我们在保留任务所需细致路由质量的同时,将推理成本降低 95% 以上,并将预处理延迟减半。如果你正在大规模运行多模态视频搜索,模型蒸馏是在不牺牲搜索准确率的前提下实现生产级成本效率的一条务实路径。若要了解完整实现,可访问 GitHub 仓库并自行试用该方案。
Amit Kalawat
Amit Kalawat 是常驻纽约的 Amazon Web Services 首席解决方案架构师。他与企业客户合作,支持其推进业务转型和上云进程。
James Wu
James Wu 是 AWS 首席生成式 AI/机器学习专家解决方案架构师,帮助企业设计并执行 AI 转型战略。他专注于生成式 AI、代理式系统和媒体供应链自动化,同时也是会议演讲嘉宾和技术作者。在加入 AWS 之前,他曾担任架构师、开发者和技术负责人超过 10 年,经验横跨工程和营销行业。
Bimal Gajjar
Bimal Gajjar 是 AWS 高级解决方案架构师,与全球大客户合作设计、采用并部署可扩展的云存储与数据解决方案。Bimal 拥有超过 25 年与领先 OEM 厂商合作的经验,包括 HPE、Dell EMC 和 Pure Storage,并结合其在售前架构和全球服务交付全流程中的实践,兼具深厚技术专长和战略业务洞察。


