MIT Technology Review 在一篇长文中回顾了机器人学习方式的近代转折。文章认为,今天机器人再度成为资本和创业热点,关键并不只是硬件进步,而是机器学习方法让机器人获取动作能力的路径变了。
早期机器人更像是被工程师穷举规则驱动的系统。以折衣服为例,开发者需要预先写出判断布料、识别衣领、抓取袖口、纠正扭转等大量规则。一旦环境变化、姿态变化或材料变化,规则数目就会迅速膨胀。
从仿真试错到多模态模型
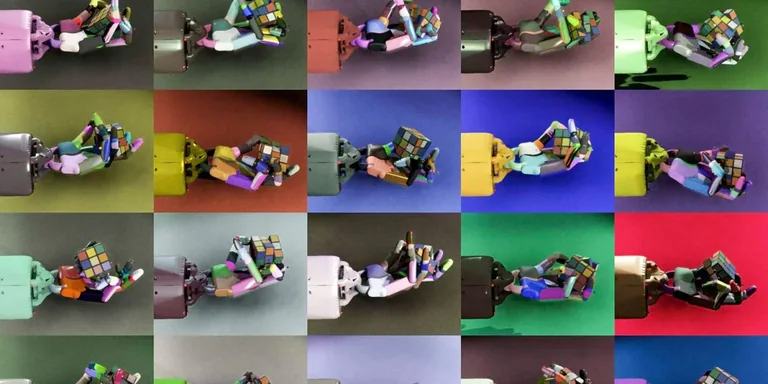
大约在 2015 年前后,研究前沿开始更多转向仿真环境里的试错训练。研究人员会构建机器人与环境的数字模拟,让系统在成功时获得奖励、失败时受到惩罚,通过海量迭代学习动作策略,这和 AI 在游戏中的强化学习路线相似。
到了 ChatGPT 问世之后,另一类方法快速进入机器人领域:把视觉、传感器读数和关节状态一起喂给类似大模型的系统,让模型直接预测下一步动作。于是,机器人学习不再只是为单一任务调规则,而是尝试从大规模数据中提炼更通用的控制能力。
能力扩展与安全挑战同时出现
文章举了 Jibo 等社交机器人作为对照:早年的产品已经能做陪伴和简单对话,但受限于脚本式语言系统,交互显得重复而生硬。今天的语音与多模态模型让社交能力明显提升,却也带来了新的安全风险,因为生成式系统并不总能保持在可控范围内。
在这套新范式下,行业重新开始押注通用机器人:一方面它承诺更强的环境适应和任务迁移能力,另一方面也把评估、对齐和安全问题一起推到了前台。


