把语言模型式能力带到机器人
Physical Intelligence 推出了新的机器人基础模型 π0.7,目标是让机器人把训练中学到的技能重新组合,呈现出类似大语言模型拼接知识片段的能力。公司把这种现象描述为机器人领域早期的“组合泛化”。
从结构上看,π0.7 建立在 Google 开源的 Gemma 3 语言模型之上,主干规模为 40 亿参数,另配有一个 8.6 亿参数的动作专家用于生成具体机器人动作。不过,团队强调真正关键的不只是模型架构,而是训练配方本身。
上下文与元数据成为训练重点
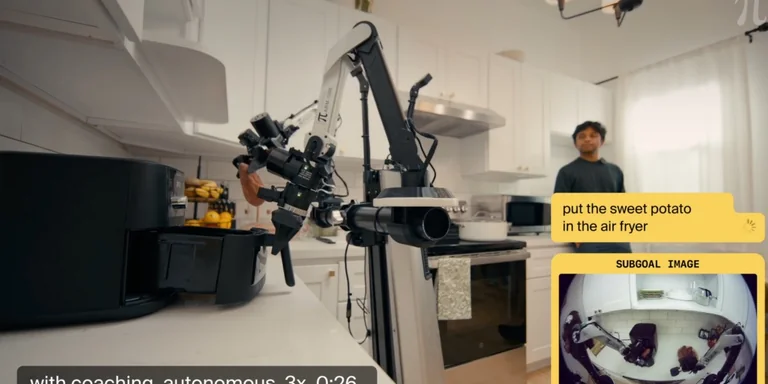
与只接收简短任务说明的旧式机器人模型不同,π0.7 在训练时还会获得子任务自然语言指令、演示质量与速度元数据、控制模式标签,以及展示中间目标结果的子目标图像。这些子目标图像由一个轻量级世界模型在运行时生成。
这种做法的直接好处,是可以把失败样本或较慢的演示也保留下来,并通过元数据告诉模型这些数据的性质,而不是简单丢弃。Physical Intelligence 认为,这让系统能够在数据质量不一的情况下继续扩展训练。
演示效果与争议并存
公司表示,单个 π0.7 模型已经能在叠衣服、做意式咖啡和搭箱等任务上达到此前经过强化学习微调的 π0.6 专项模型水平。它还声称,双臂 UR5e 工业机械臂在没有收集过叠衣训练数据的情况下,零样本完成 T 恤折叠的成功率达到 80%。
不过,围绕“空气炸锅放红薯”的演示,争议也随之出现。技术报告称训练集中几乎没有对应任务,但相关公开数据里已有机械臂打开空气炸锅抽屉并放入物体的样本。问题因此转向:π0.7 是真的学会了泛化,还是只是把非常相近的训练经验重新混合。报告本身也承认,在庞大且多样的数据集里,很难绝对确认哪些任务是真正全新的。
机器人开始面对与大模型相同的问题
这使机器人基础模型开始遇到与大语言模型相似的核心难题:提示方式越来越重要,性能高度依赖上下文,而“真正泛化”“相似任务重混”与“检索到近似样本”之间的边界变得难以划清。
报告中的消融实验还显示,元数据对扩展能力很重要。缺少质量标注时,加入更多但质量更低的数据会让模型表现变差;加入元数据后,模型仍能继续从新增数据中获益。至于更复杂的“先思考再行动”式推理能力,团队只在结尾提到未来可能探索,当前 π0.7 还没有走到这一步。


