英伟达研究人员发布了 Lyra 2.0,这是一套可从单张照片生成大规模、连贯 3D 环境的系统。生成后的场景可以实时探索,并可直接用于机器人仿真。
现有用于 3D 场景生成的 AI 模型在处理长镜头路径时表现不佳:虚拟相机离起点越远,颜色和结构越容易发生畸变。当相机回到先前见过的位置时,模型往往会把环境重新生成一遍。英伟达研究人员希望用 Lyra 2.0 解决这一问题。
该系统接收一张照片,生成由相机控制的视频,以模拟在场景中的虚拟漫游。随后,这些视频会被自动转换为 3D 表示,可实时查看并用于仿真环境。根据论文,生成场景的跨度大约可达 90 米。
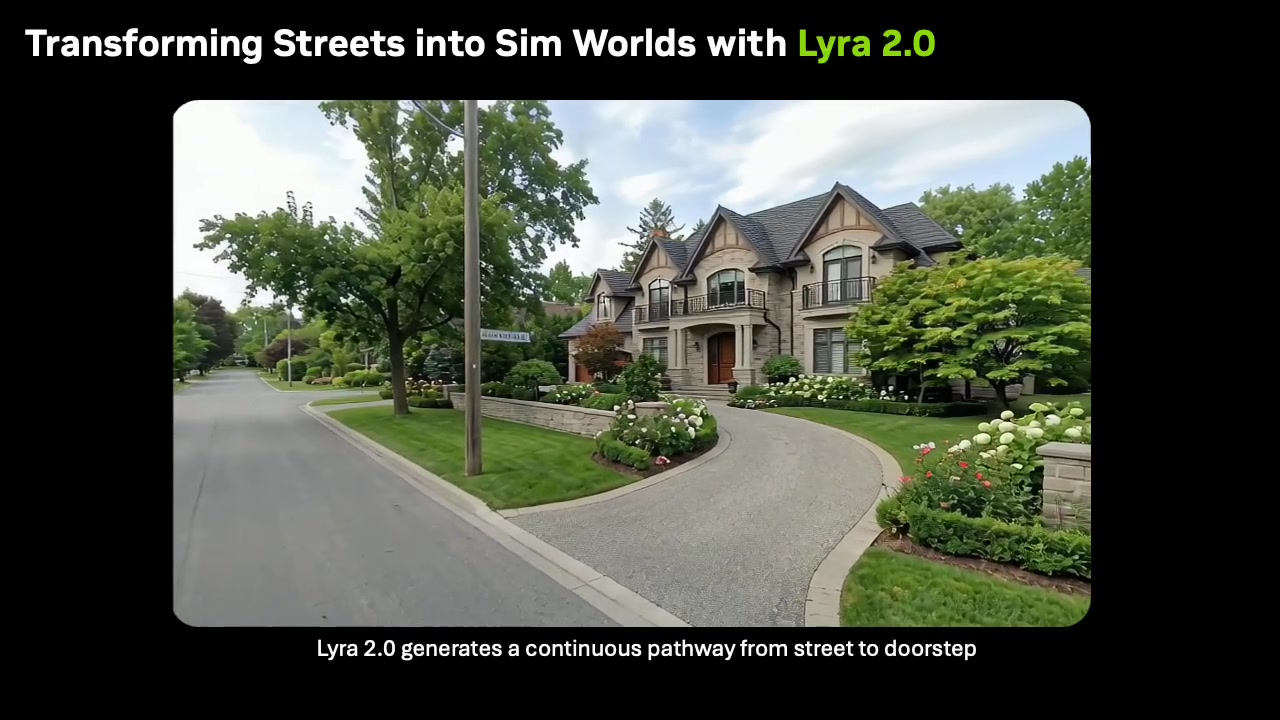
Lyra 2.0 如何解决 3D 场景生成中的两个最大问题
研究人员称,当前视频模型在两个基本挑战上存在不足。首先,一旦某个区域离开画面,模型就会忘记此前看到的内容。其次,在逐步生成视频的过程中,微小误差会不断累积,久而久之形成明显畸变。
为解决第一个问题,Lyra 2.0 会存储每一帧生成结果对应的 3D 几何信息。当相机移回先前访问过的区域时,系统会调取较早的帧,并将其中的空间信息作为参考。实际图像生成仍由视频模型完成,这意味着已存储几何中的错误不会直接渗入新帧。
为防止漂移,研究人员在训练过程中有意让模型接触自身存在缺陷的输出。这让它学会识别并纠正质量下降,而不是继续传递错误。
Lyra 2.0 优于六种竞争方法
英伟达表示,在两个数据集的基准测试中,Lyra 2.0 在图像质量、风格一致性和相机控制等几乎所有测量指标上都优于另外六种方法,其中包括 GEN3C、Yume-1.5 和 CaM。该模型的一个更快版本在相近质量下,视频生成速度约快 13 倍。
生成的 3D 场景可通过交互式界面逐步探索,也可导出为网格并用于 Nvidia Isaac Sim 等物理引擎。公司称,这可能让机器人在完全生成的环境中训练,而无需采集现实世界的 3D 数据。不过,目前 Lyra 2.0 只支持静态场景。


