我们最新的音频模型引入了细粒度音频标签,让你能够进行精确控制,引导 AI 语音生成更具表现力的音频。
总体概述
Gemini 3.1 Flash TTS 已正式推出,为你带来更好的 AI 语音质量和控制能力。你现在可以通过音频标签,在 70 多种语言中调整发声风格和节奏。你可以在 Google AI Studio、Vertex AI 和 Google Vids 中进行体验,同时需要知道,所有音频都带有 SynthID 水印,以防止错误信息传播。
要点
“Gemini 3.1 Flash TTS”是一款新的 AI 语音模型,在控制能力、表现力和质量方面都有所提升。该模型改进了语音质量,让声音比之前的版本更自然。音频标签允许你使用自然语言命令控制发声风格、语速和表达方式。开发者可以使用 Google AI Studio 微调声音并导出设置,以便持续一致地使用。Gemini 3.1 Flash TTS 支持 70 多种语言,并使用 SynthID 水印来识别 AI 生成音频。
基础说明
Gemini 3.1 Flash TTS 是一种新的 AI,可让计算机语音听起来更真实。它允许人们通过文本中的特殊指令来改变 AI 的说话方式。这一 AI 可以使用 70 多种语言发声,并会在音频中加入隐藏水印。这有助于人们识别它是由 AI 生成的,而不是真人。
探索其他风格:
你的浏览器不支持音频元素。
今天,我们推出 Gemini 3.1 Flash TTS。这是最新的文本转语音模型,在可控性、表现力和质量方面都有所提升,帮助开发者、企业和普通用户构建下一代 AI 语音应用。
从今天开始,3.1 Flash TTS 正在陆续推出:
提升后的语音质量与控制能力
我们提升了 Gemini 3.1 Flash TTS 的整体语音质量,使其成为迄今为止我们最自然、最具表现力的模型。在 Artificial Analysis TTS 排行榜上,这一基于数千份人类盲测偏好的基准中,3.1 Flash TTS 取得了 1,211 的 Elo 分数。
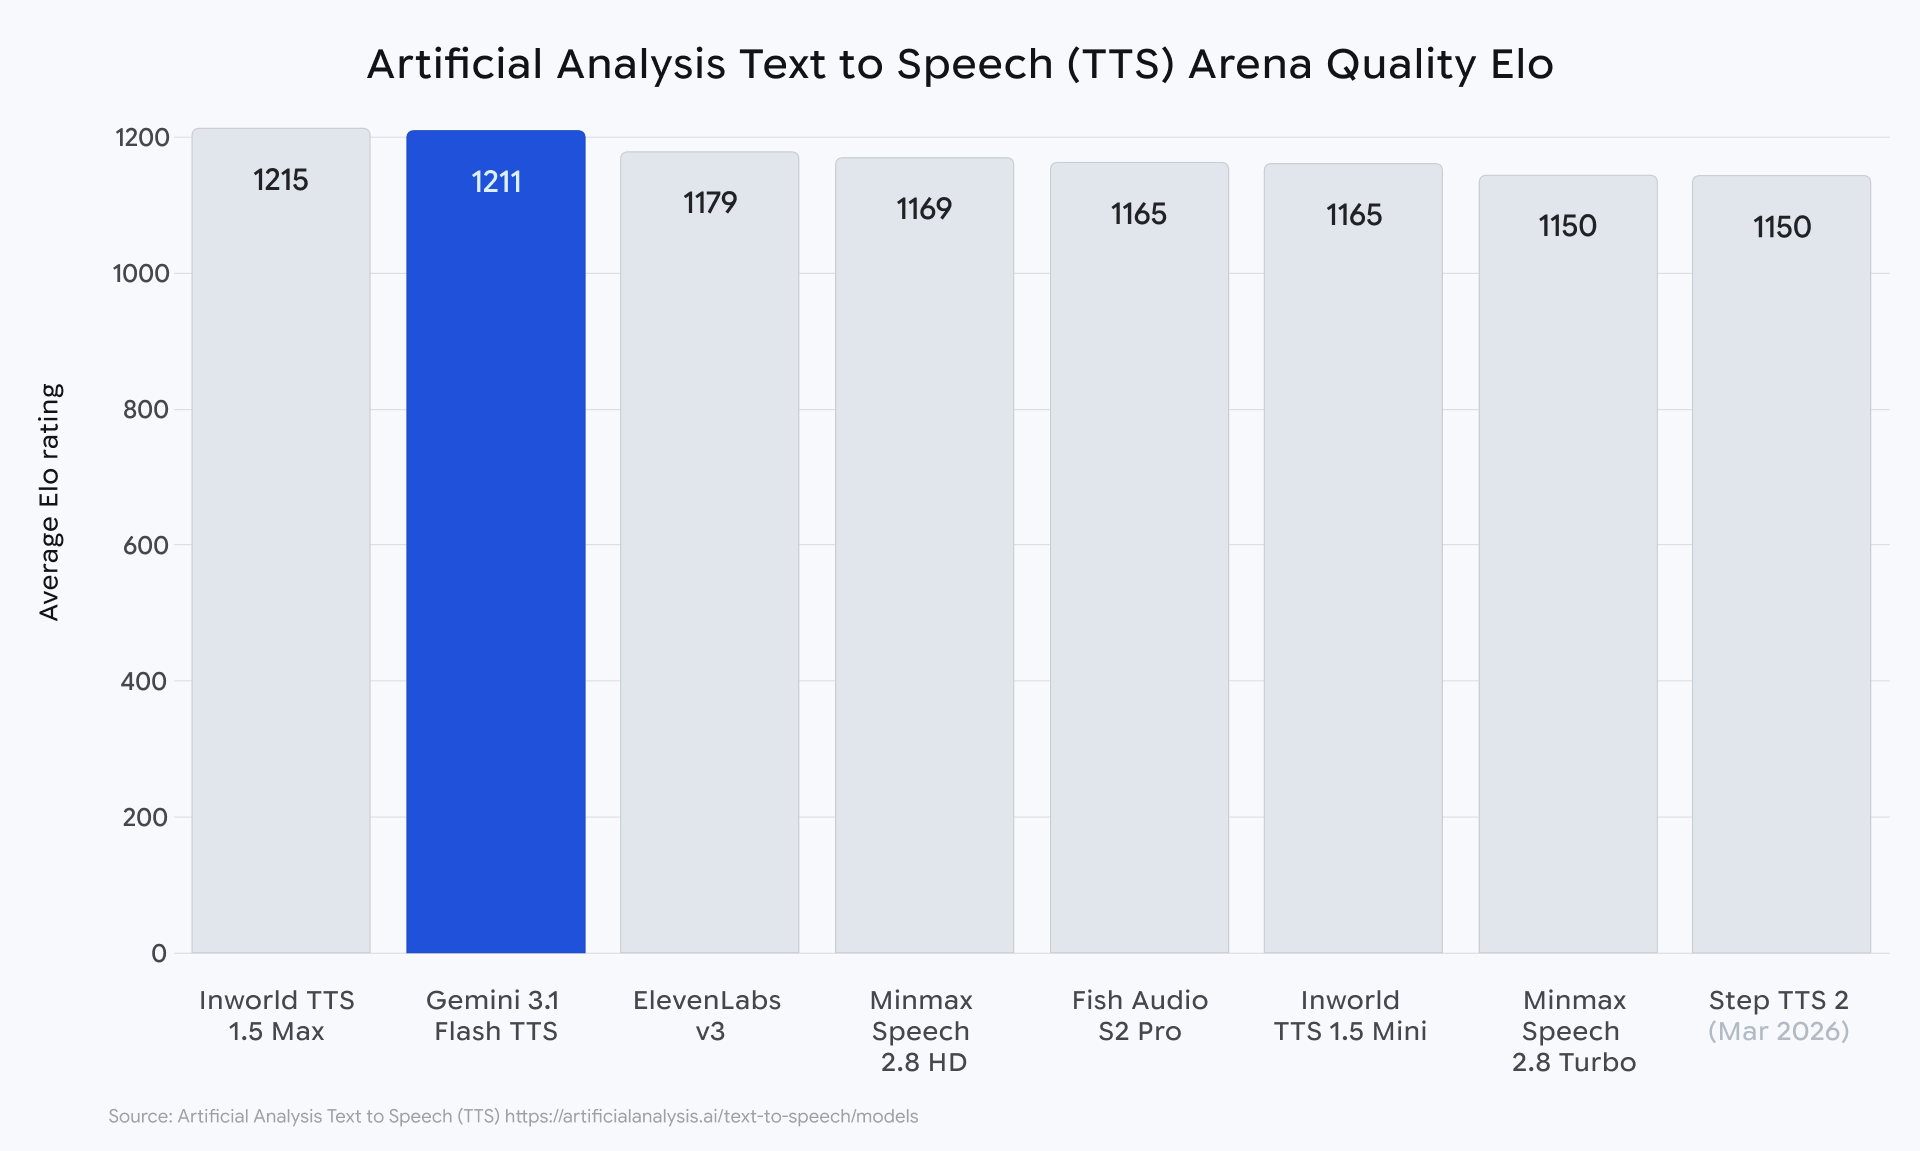
Artificial Analysis 还将 Gemini 3.1 Flash TTS 置于其“最具吸引力象限”中,原因是它在高质量语音生成与低成本之间实现了理想平衡。该模型还凭借原生多说话人对话、对 70 多种语言的支持,以及通过自然语言实现的细粒度创意控制而进一步脱颖而出。
新的音频标签带来更具表现力的语音生成
3.1 Flash TTS 还引入了音频标签,这是一种控制发声风格、语速和表达方式的直观方法。通过将自然语言命令直接嵌入文本输入中,你可以以更细的粒度引导 AI 语音输出。
你现在可以在 Google AI Studio 中开始试用这些音频标签,以及开发者体验的其他更新;其中提供了可配置控件,让开发者坐上“导演席”:
通过这些新配置,开发者可以在特定场景中提高精确性,打造令人难忘的角色和沉浸式音频体验。
你可以在 Google AI Studio Playground 中开始体验高保真语音生成。
面向全球规模构建
Gemini 3.1 Flash TTS 在 70 多种语言中提供高保真语音和更精确的控制。这些核心优化将高级风格、节奏和口音控制带到主要市场,帮助开发者面向全球规模的用户打造本地化且富有表现力的语音体验。
早期开发者和企业测试者已经开始看到 3.1 Flash TTS 的影响,并强调了其出色的可控性和表现力。他们告诉我们,音频标签带来了新的创意精度水平,可将简单文本转化为高保真的语音演绎。
通过 SynthID 添加水印
由 Gemini 3.1 Flash TTS 生成的所有音频都带有 SynthID 水印。这种不可感知的水印被直接嵌入音频输出中,能够可靠地检测 AI 生成内容,从而帮助防止错误信息传播。有关我们在安全性和责任方面的方法的更多信息,你可以查阅模型卡。


