我们最新的音乐生成模型现已向开发者开放公开预览。
正在准备视频内容
00:00 / 00:00
你的浏览器不支持音频元素。
我们的音乐生成模型 Lyria 3 和 Lyria 3 Pro 现正通过 Gemini API 以及 Google AI Studio 中全新的音频体验,向开发者逐步开放公开预览。
Lyria 3 旨在将深度音乐理解与结构连贯性结合起来。这让开发者能够构建可提供高保真音乐作品的应用,这些作品包括人声、主歌和副歌,并能从第一个音符到最后一个音符保持音乐上的一致性。
录音室级品质与速度
开发者现在可以在两个不同的模型变体之间进行选择,以满足特定的制作和延迟要求:
两款模型都支持能够传达细腻表现力的真实人声,并提升了清晰度,使声音更加自然。开发者还可以探索全球语言和音乐风格,生成人声时支持不同语言,并创作涵盖 pop、funk 到 Motown 等风格的音乐。
精细控制与多模态输入
Lyria 3 引入了细粒度控制,让你能够通过自然语言提示对模型进行精确引导:
Lyria 3 的实际应用
为了展示你可以如何将这一模型整合进应用,我们在 Google AI Studio 中构建了一些示例:
在 Google AI Studio 中试用 Lyria 3
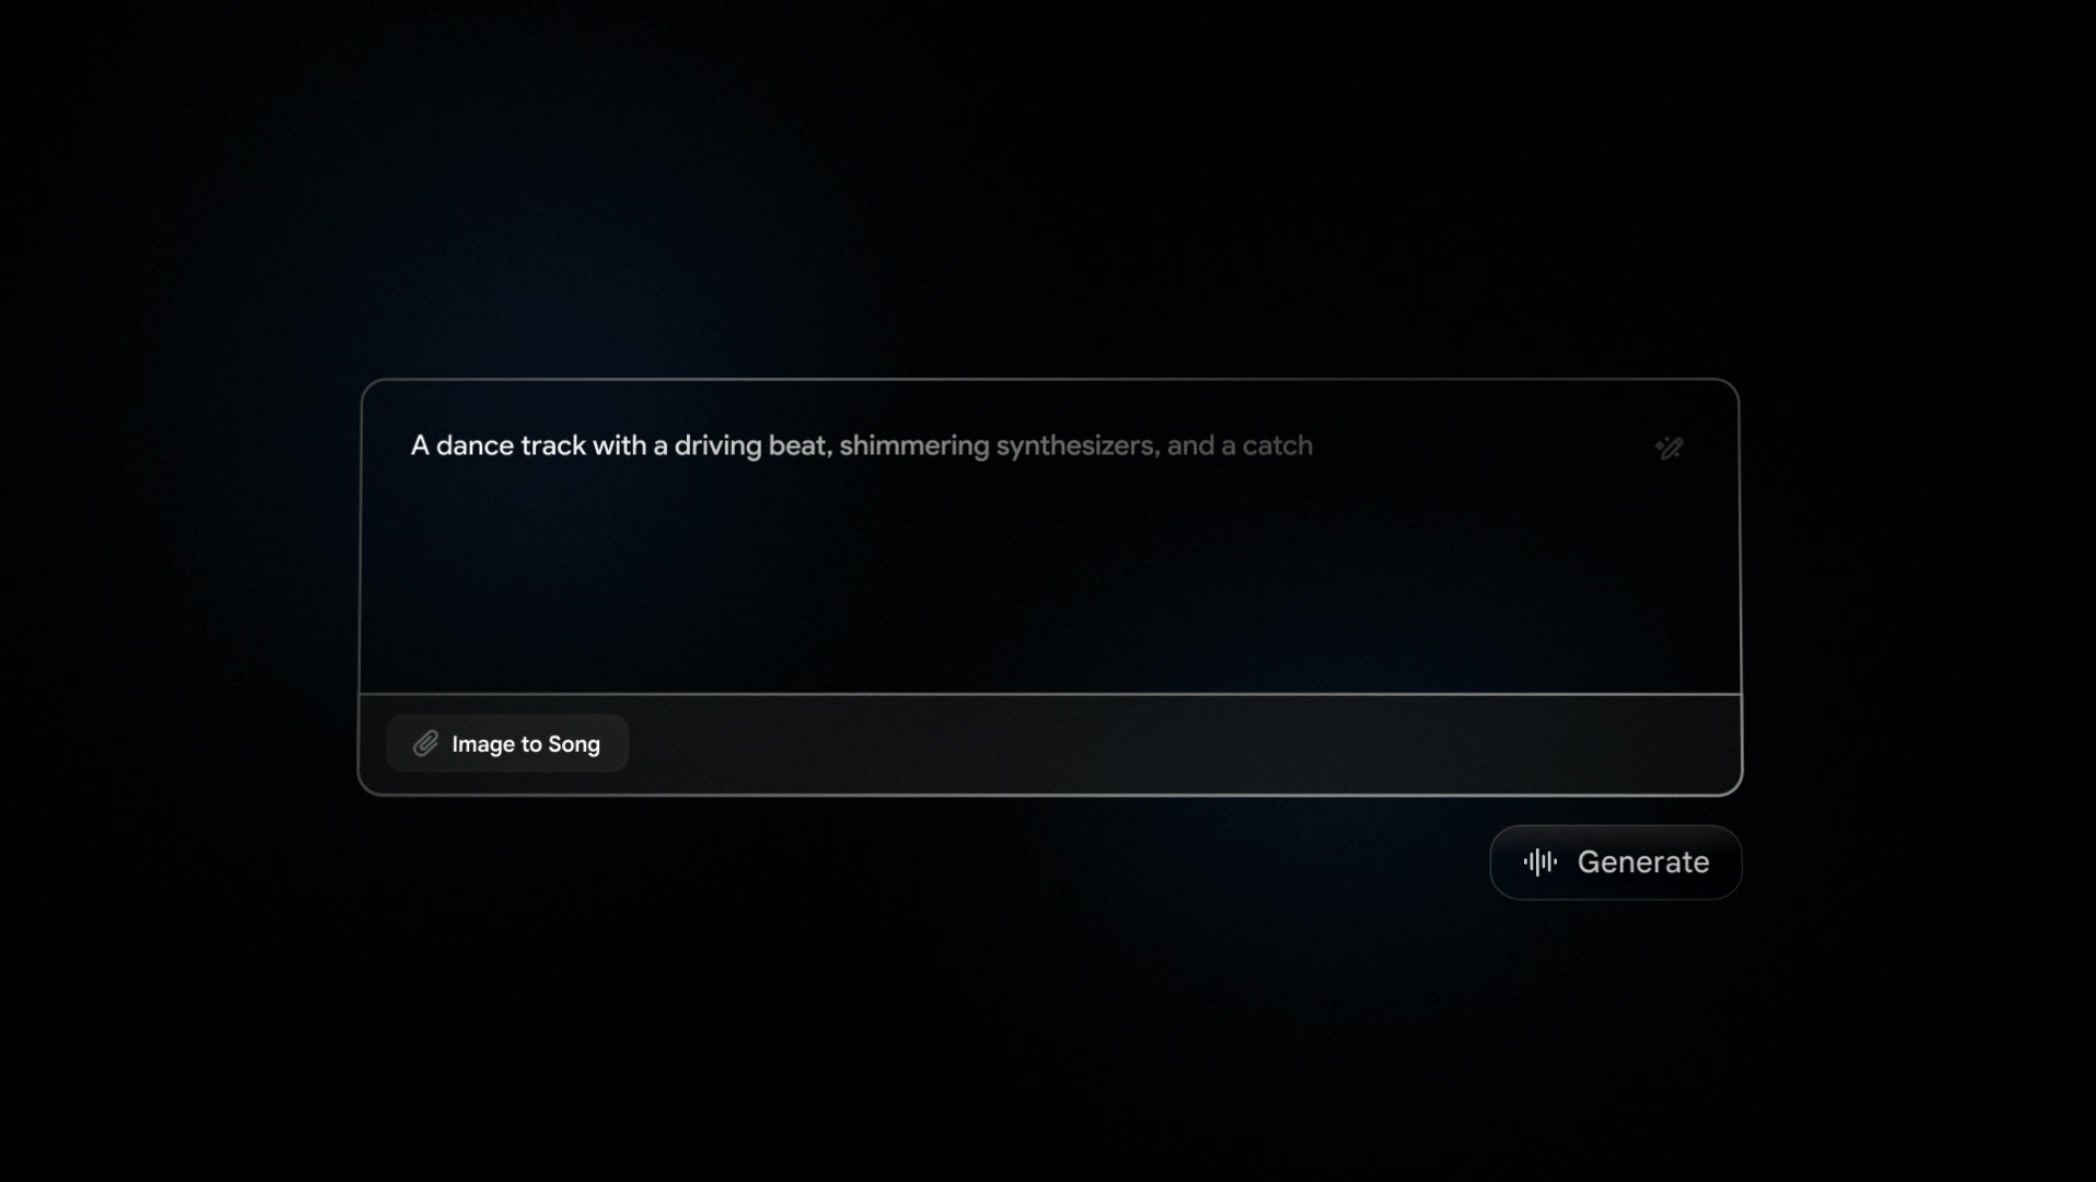
为了帮助你立即开始试验,我们也在 AI Studio 中推出了全新的音乐生成体验。借助付费 API 密钥,这个专用工作区为使用 Lyria 3 进行创作并探索 image to music 等高级功能提供了专门的环境。
在这个 playground 中,你可以探索两种强大的音乐创作模式:


