导语
TurboQuant 使 AI 模型更高效,并且不像其他方法那样会降低输出质量。
即使您对生成式 AI 模型的工作原理了解不多,您可能也知道它们需要大量内存。因此,目前几乎不可能在不被‘宰’的情况下购买一根内存条。Google Research 最近公布了 TurboQuant,这是一种压缩算法,它能减少大型语言模型 (LLM) 的内存占用,同时提高速度并保持准确性。
TurboQuant 旨在减小关键值缓存 (key-value cache) 的大小,Google 将其比作一个“数字备忘录”,用于存储重要信息,避免重复计算。这个备忘录之所以必要,是因为正如我们经常所说,LLM 实际上并不知道任何事物;它们通过使用向量来模拟知识,这些向量映射了分词文本的语义含义。当两个向量相似时,意味着它们具有概念上的相似性。
核心信息
高维向量,可能包含数百或数千个嵌入(embeddings),可以描述像图像中的像素或大型数据集等复杂信息。它们还会占用大量内存,膨胀关键值缓存的大小,从而限制性能。为了使模型更小、更高效,开发人员会采用量化技术以较低的精度运行它们。缺点是输出会变差——标记(token)估计的质量会下降。借助 TurboQuant,Google 的早期结果显示,在某些测试中,性能提高了 8 倍,内存使用量减少了 6 倍,而质量没有损失。
将 TurboQuant 应用于 AI 模型是一个两步过程。为了实现高质量压缩,Google 设计了一个名为 PolarQuant 的系统。通常,AI 模型中的向量使用标准的 XYZ 坐标进行编码,但 PolarQuant 将向量转换为笛卡尔坐标系中的极坐标。在这个圆形网格上,向量被简化为两部分信息:半径(核心数据强度)和方向(数据的含义)。
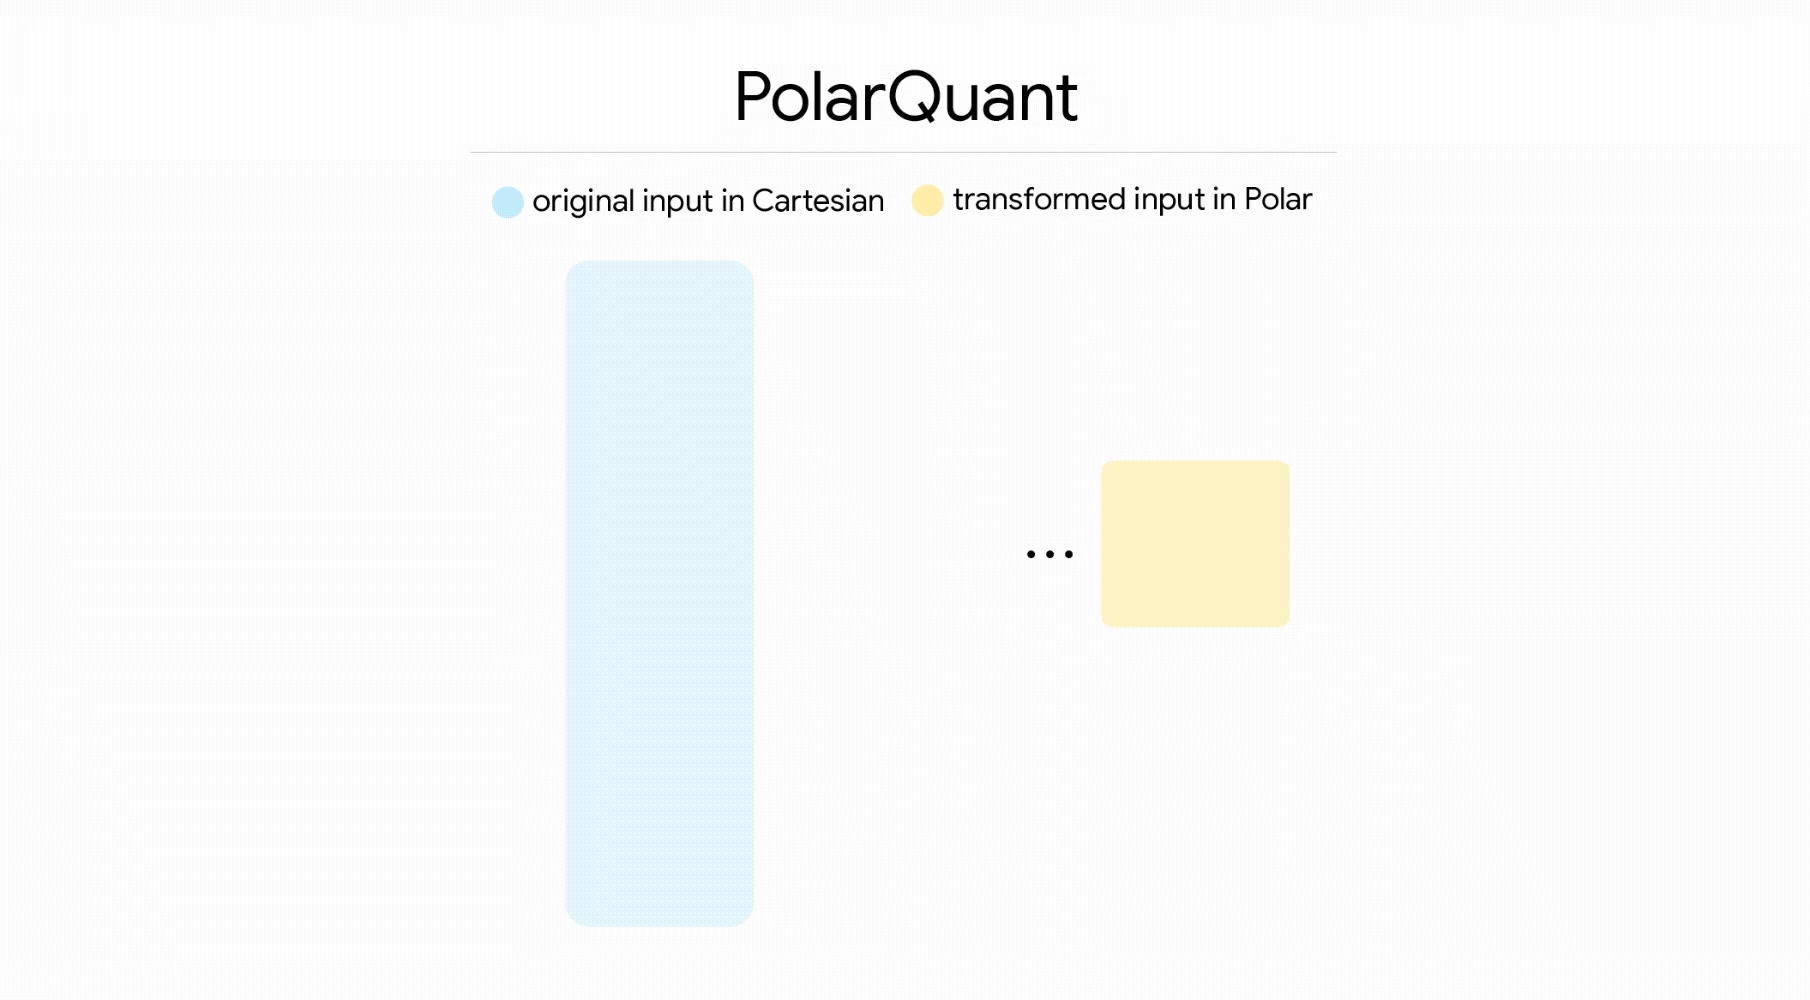
Google 提供了一个有趣的现实世界类比来解释这个过程。向量坐标就像方向,所以传统的编码可能是‘向东走 3 个街区,向北走 4 个街区’。但使用极坐标,它只是‘以 37 度角走 5 个街区’。这占用的空间更少,并避免了系统执行昂贵的数据归一化步骤。
更多细节
PolarQuant 负责大部分压缩工作,但第二步可以清理粗糙的部分。虽然 PolarQuant 很有效,但它可能会产生残留错误。Google 提出使用一种名为 Quantized Johnson-Lindenstrauss (QJL) 的技术来平滑这些误差。它为模型应用了一个 1 比特的纠错层,将每个向量简化为单个比特(+1 或 -1),同时保留描述关系的基本向量数据。其结果是更准确的注意力分数(attention score)——这是神经网络决定哪些数据重要的基本过程。如果您对更多细节感兴趣,可以下载预印本论文。
那么,所有这些数学计算都奏效吗?Google 表示,他们使用 Gemma 和 Mistral 等开源模型,在一系列长上下文基准测试中测试了这种新的算法压缩技术。TurboQuant 在所有测试中似乎都取得了完美的下游结果,同时将关键值缓存的内存使用量减少了 6 倍。该算法可以将缓存量化到仅 3 比特,无需额外训练,因此可以应用于现有模型。在 Nvidia H100 加速器上,使用 4 比特 TurboQuant 计算注意力分数比 32 比特未量化键的速度快 8 倍。
如果实施 TurboQuant,可能会使 AI 模型运行成本更低,内存需求更小。然而,创建这项技术的公司也可以利用新释放的内存来运行更复杂的模型。这很可能是一个两方面结合的结果,但移动 AI 可能会从中获得更多好处。考虑到智能手机的硬件限制,像 TurboQuant 这样的压缩技术可以在不将您的数据发送到云端的情况下,提高输出质量。
影响与观察
Ars Technica 二十五年多来一直致力于在海量信息中分辨有价值的内容。凭借我们独特的专业技术和对技术艺术与科学的广泛兴趣,Ars 是值得信赖的信息来源。毕竟,您不必了解一切,只需了解重要的内容即可。


