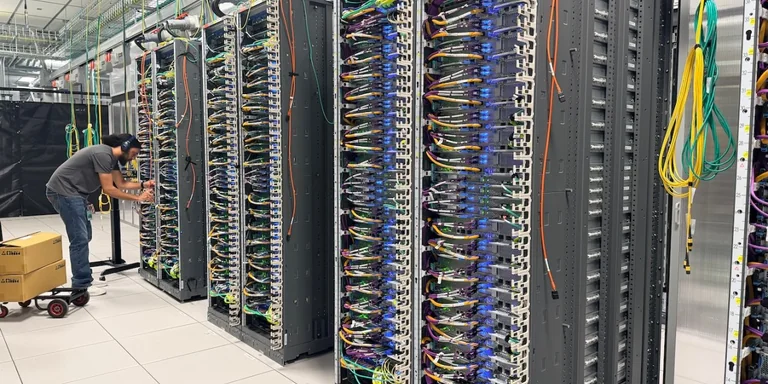
在 AWS 宣布与 OpenAI 达成 500 亿美元投资合作后不久,TechCrunch 受邀参观了亚马逊芯片开发实验室。报道指出,这个实验室的核心成果 Trainium 正在成为外界观察亚马逊如何切入 AI 基础设施竞争的关键样本,尤其是在 AI 推理成本居高不下、Nvidia 仍保持近乎垄断的背景下。
AWS 方面表示,OpenAI 之所以愿意加深与亚马逊的合作,一个重要原因是 AWS 将向其提供 2 吉瓦的 Trainium 计算能力。这一承诺相当激进,因为 Anthropic 与 Amazon 自家的 Bedrock 服务已经在快速消耗 Trainium 芯片产能。亚马逊称,目前三代 Trainium 芯片累计部署量达到 140 万片,其中 Claude 已运行在超过 100 万片已部署的 Trainium2 芯片上。
报道特别强调,Trainium 的重心已经从早期更偏训练,转向同时服务推理。对当前 AI 行业来说,真正的性能瓶颈更多在推理侧,也就是模型实际生成回答时的吞吐、延迟与成本。作为例证,Trainium2 已承担 Amazon Bedrock 上的大部分推理流量,而 Bedrock 又是大量企业客户构建 AI 应用时使用的多模型平台。
亚马逊给出的竞争点很明确:除了为开发者提供 Nvidia GPU 之外的另一条路,新芯片在特定 Trn3 UltraServer 上能够在可比性能下把运行成本最高降低 50%。配合 2025 年 12 月发布的 Trainium3,以及新的 Neuron 交换机,AWS 希望通过更高效的芯片互联降低延迟,让每一颗 Trainium3 都能在 mesh 配置中与其他芯片通信。
AWS 工程团队认为,这种互联能力对大规模推理尤为关键,因为当系统每天要处理数万亿 token 时,单点的延迟与功耗优化都会被显著放大。报道中,工程负责人甚至把 Trainium3 的优势描述为“正在打破各种纪录”,尤其是在价格与功耗表现上。
亚马逊也意识到,真正阻碍客户迁移的并不只是芯片价格,而是生态切换成本。过去很多应用都是围绕 Nvidia 生态开发的,如果改用其他芯片,往往意味着重构。为此,AWS 团队强调 Trainium 现在已经支持 PyTorch,也兼容 Hugging Face 上许多开源模型。按工程主管的说法,迁移在很多情况下只需要“改一行代码、重新编译、然后在 Trainium 上运行”。
报道还提到一个有意思的侧面:Apple 曾在 2024 年公开称赞过亚马逊芯片团队,为其 Graviton、Inferentia 以及当时刚推出不久的 Trainium 点赞。再加上 Anthropic 长期把 AWS 作为主要云平台、OpenAI 又在新合作中大幅引入 Trainium 产能,这意味着亚马逊正在同时从价格、供给和兼容性三条线试图撬动 Nvidia 的市场地位。
此外,AWS 本月还宣布与 Cerebras Systems 合作,把后者的推理芯片整合到运行 Trainium 的服务器上,进一步强化低延迟 AI 服务能力。整体来看,Trainium 已不再只是亚马逊内部的一条自研芯片支线,而是其争夺下一阶段 AI 基础设施控制权的重要筹码。


